每秒1000 Token:扩散式大模型如何解开智能体的延迟瓶颈
一条被低估的产品新闻
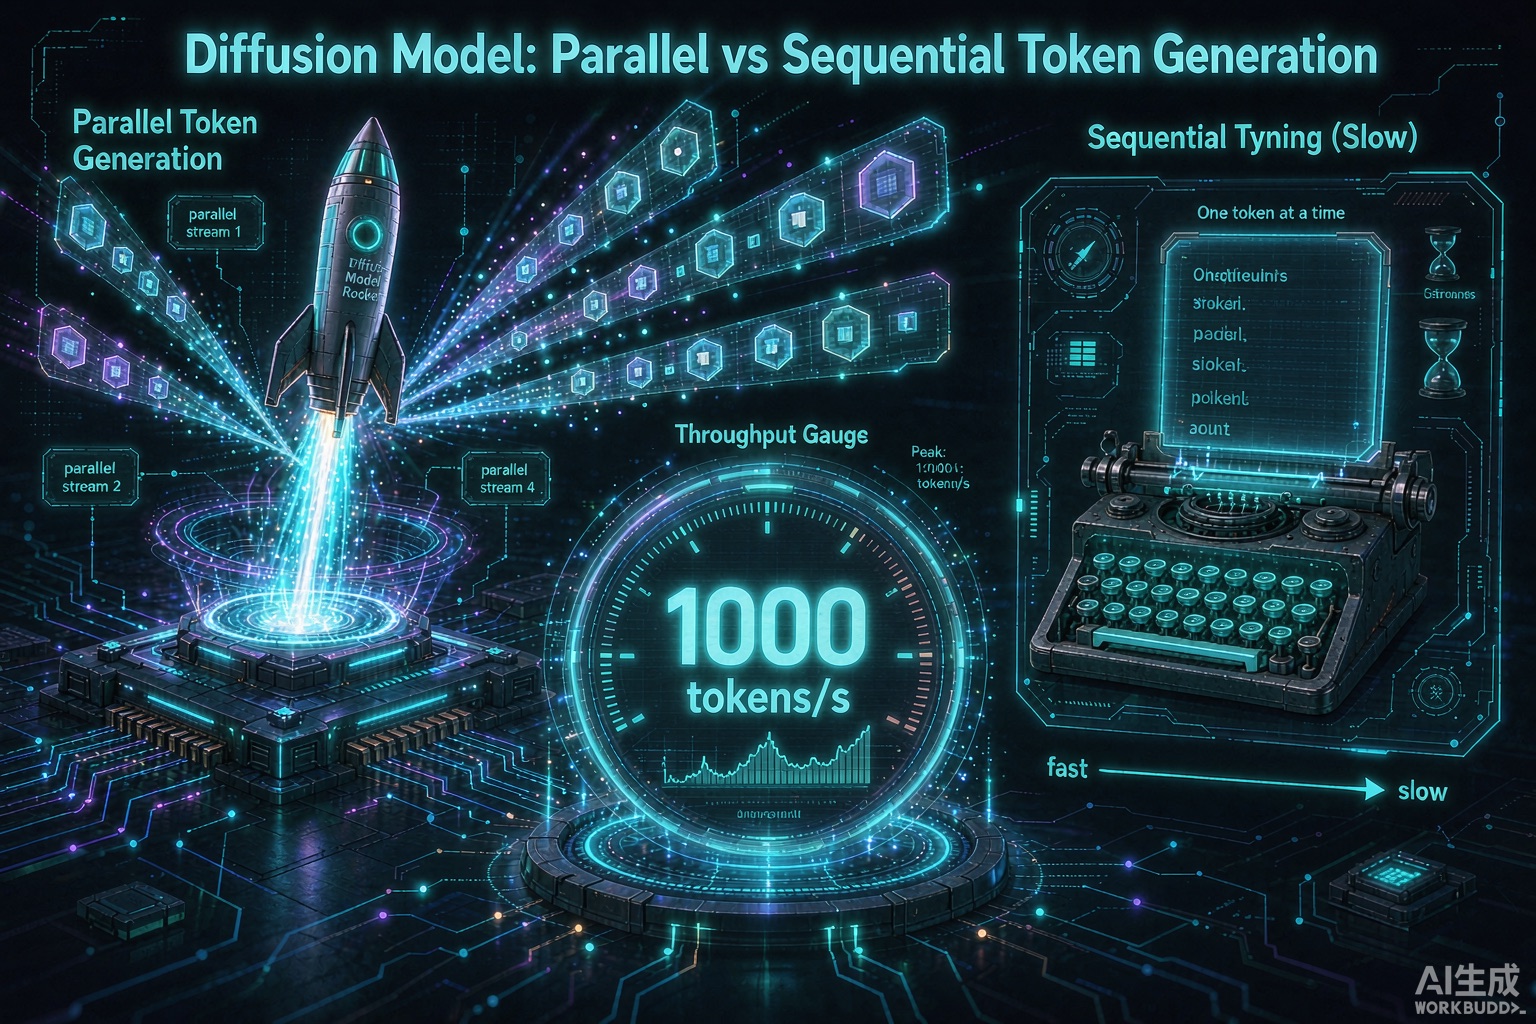
Inception发布Mercury 3:基于扩散架构的语言模型,不走“一个token接一个token”的自回归老路,而是并行生成,在Nvidia芯片上跑出每秒1000+ Token的速度,上下文窗口扩到100万,官方基准宣称对GPT-6 Luna、Claude Haiku 5.5有4-8倍速度优势。
速度为什么是智能体的命门
单次对话里,快慢只是体验差异;但在智能体场景,速度是成本和可行性的分水岭:
- 一个智能体完成任务平均要调用模型20-50次,每次都等3秒,用户早就走了
- 多智能体协作时,调用次数相乘,延迟指数级放大
- 实时场景(电话客服、驾驶辅助)里,慢等于不可用
Mercury 3把单次调用压到亚秒级,等于把智能体的“呼吸频率”提高了一个量级。
扩散式生成是什么思路
传统模型像写字:一笔一划从头写到尾。扩散模型像修图:先出一整幅草稿,再逐轮精修全部区域。并行处理带来的吞吐提升,正好匹配智能体“大量小请求”的调用模式。1M上下文还能让智能体把整个项目文档装进脑子里,减少反复检索。
给企业的三个判断
- 选型加入速度维度:同样的能力,快3倍的模型在智能体场景价值远超3倍
- 关注架构拐点:自回归不再是唯一选项,未来两年模型采购要多一份“架构对比”
- 重新设计交互:模型够快后,很多“异步等待”的产品设计可以改回“实时对话”,体验会代差式提升
结语
智能体大战打到今天,大家卷完了能力和价格,下一个战场是延迟。谁先把“敢实时”变成默认体验,谁就拿下下一代AI产品的定义权。