AWS给出多智能体身份架构:权限要下沉到数据层
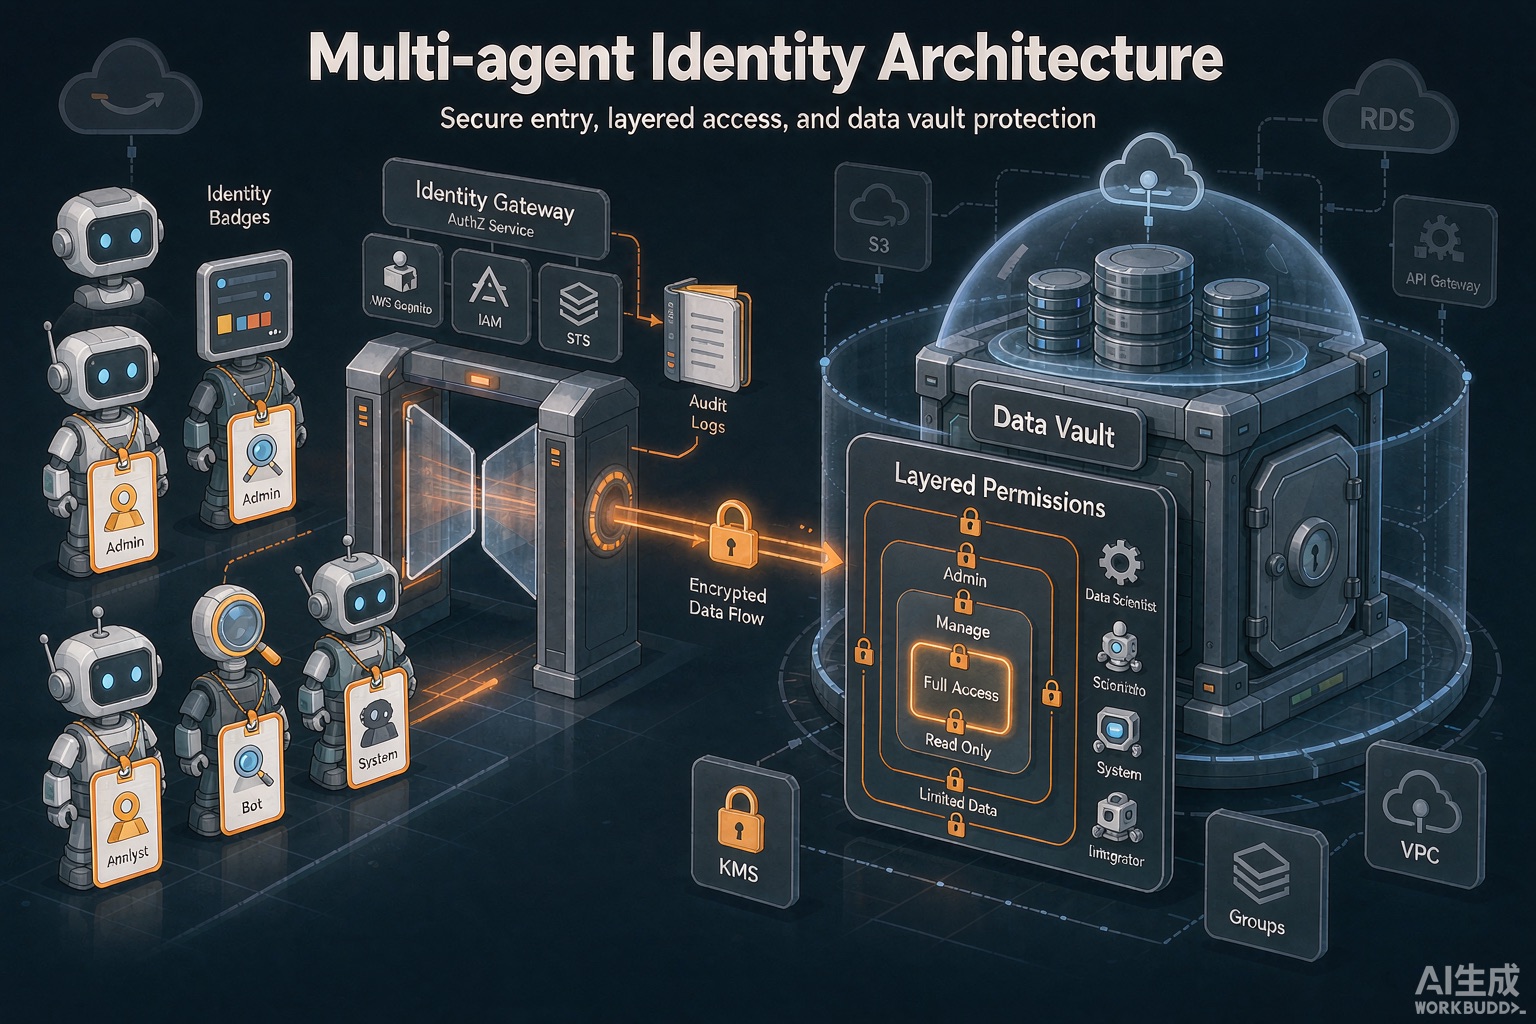
智能体需要“身份证”
AWS发布了一套多智能体系统的加密身份参考架构:结合Keyfactor EJBCA与自家服务,给每个智能体签发加密身份,用签名请求信封、用户签名的委托证明、基于RFC 8693的令牌和OCSP实时证书吊销检查,防止智能体互调和MCP工具调用中的请求伪造。
一句话概括:用可验证的方式记录“这个智能体替谁、在请求什么”。
更关键的一步:权限下沉到数据层
AWS同步发布了在Bedrock AgentCore之上叠加语义层的指南(提供Denodo、Strategy Mosaic、AtScale三个版本)。核心思想:
- 行级、列级访问控制和审计日志,做在语义层,而不是提示词里
- 智能体拿到的是“它被允许看到的数据视图”,而不是原始数据库
为什么这很重要? 写在提示词里的权限(“你不许访问财务表”)是建议,写在数据层的权限是物理边界。前者靠模型自觉,后者靠系统强制。
三个落地组件
1. 身份层
每个智能体有独立加密身份,调用可追溯到具体智能体+委托人。
2. 语义层
数据按业务含义切分视图,行级列级权限在数据出口强制执行。
3. 注册中心
AWS Agent Registry支持运行时通过语义搜索发现并连接MCP服务器和A2A智能体——连接动作从“开发期写死”变成“运行期管理”,谁能连什么由注册中心+身份系统实时裁决。
给企业的启示
准备上多智能体的团队,架构设计顺序应该是:先定身份和数据权限,再谈模型能力。Eon的案例佐证了这条路的价值——把散落在各工具的凭证和本地MCP进程收进统一的AgentCore网关后,新工程师接入从两天缩到两分钟。
结语
智能体架构的成熟标志,不是能干多少活,而是权限长在系统里、审计长在流程里。AWS这份参考架构值得每个技术负责人精读。